- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读:用图形语法拆解 Seaborn
早期在 Python 里画统计图,几乎只有 Matplotlib 可选——每张图都要手工调十几处参数,分组聚合、置信区间、配色图例全得自己搭;读研究生的 Michael Waskom 做神经数据分析时被这种重复磨烦了,索性在 Matplotlib 之上包出 Seaborn,让"DataFrame 列名进、统计图出"成为日常。从那以后,它替统计作图立下了规矩:你声明数据与映射,图形语法替你操心其余。本教程要拆解的,正是这套语法。
本教程把 Seaborn 的每一张图都放上"拆解台":数据 → 映射 → 图层 → 细节。数据是原料,长什么样、是宽表还是长表决定了后续所有操作的难度;映射是语法核心,哪个列上 x 轴、哪个列管颜色、哪个列控制点的大小;图层是叠加方式,直方图上叠核密度、散点上叠回归线;细节是最后的打磨,配色、去边框、图例位置。四层拆开,任何一个参数你都知道它属于哪一层、动了会影响什么。
Seaborn 是构建在 Matplotlib 之上的 Python 统计可视化库。它不替代 Matplotlib,而是接管了统计图形中最繁琐的部分:聚合、分组、配色、图例,并让 Pandas 的 DataFrame 列名直接成为绘图参数。sns.scatterplot(data=tips, x='total_bill', y='tip', hue='time') 一行就完成了取数、映射、分组、着色、图例五件事。
全册知识地图
九章的前后依赖关系如下:第一章建立"图形语法"这套分析语言;第二到五章按图形家族(分布、关系、分类、矩阵)逐族拆解,每族都从 Axes 级函数讲到 Figure 级工厂函数;第六章把映射里的"颜色"和细节层的"风格"系统化;第七章进入多面板与生态集成;第八章用完整案例把前七章的零件装配起来;第九章处理性能、边界与选型。
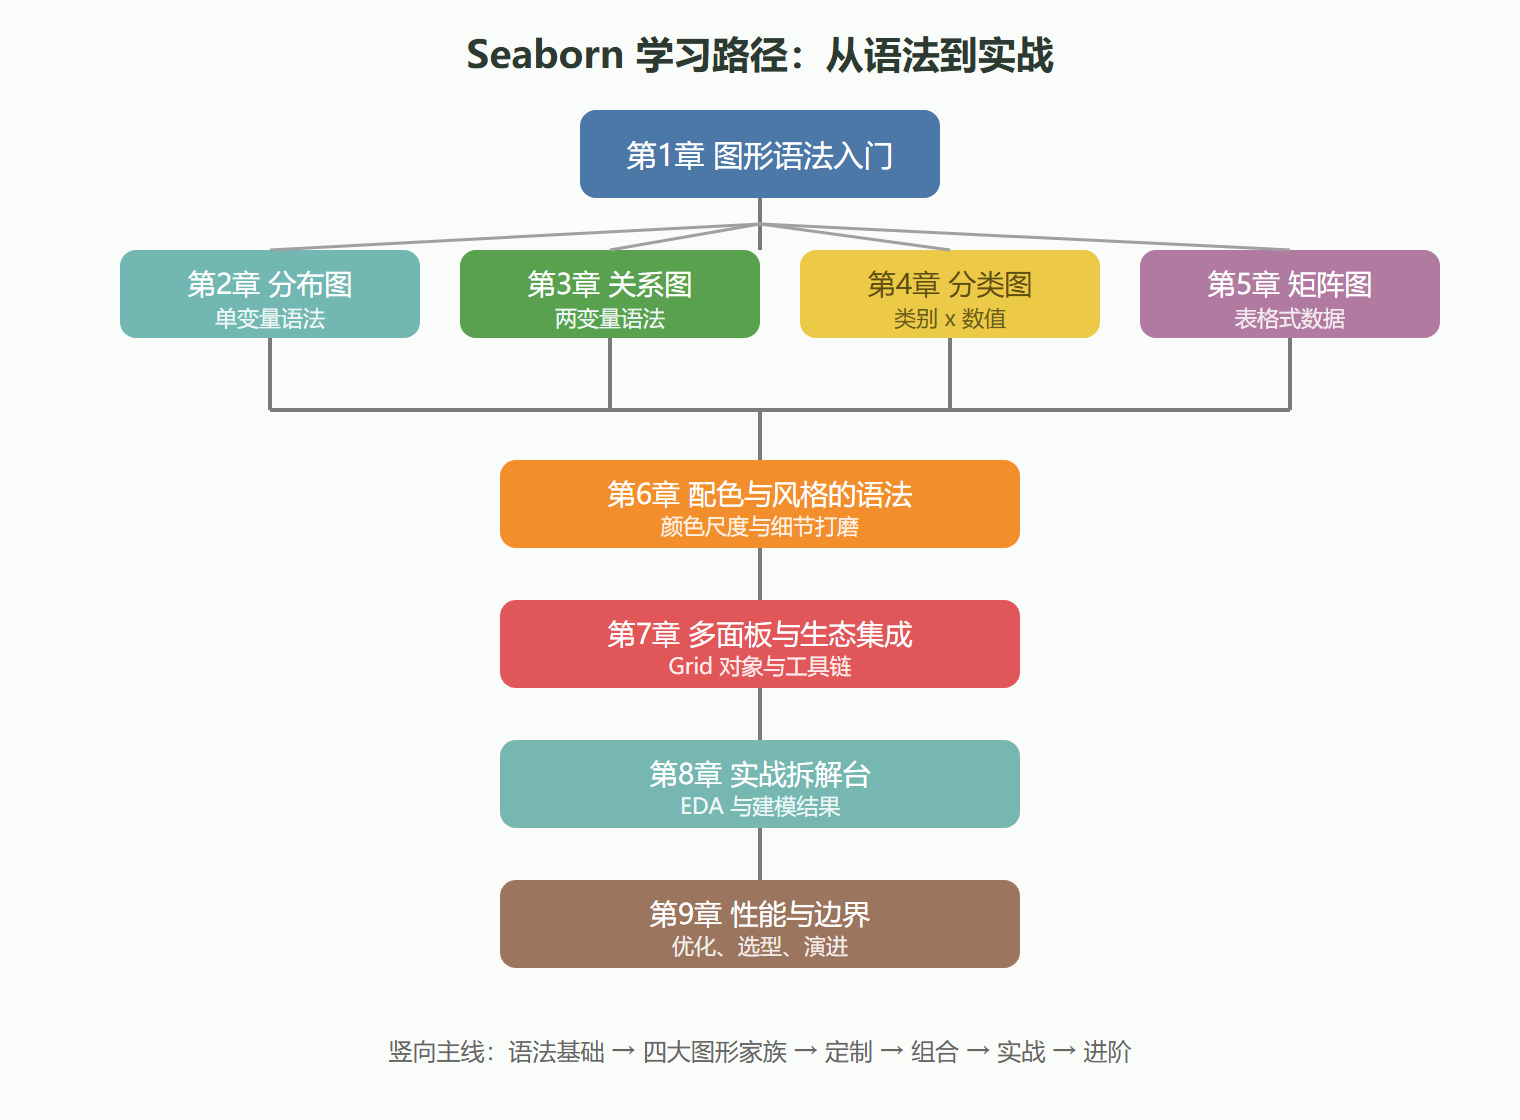
各章一句话导览
- 第 1 章:装好环境,学会用"数据、映射、图层、细节"四层去看任何一张 Seaborn 图。
- 第 2 章:直方图、核密度、经验分布,分布家族的映射只围绕"一个数值列"展开。
- 第 3 章:散点与折线,两个数值列的关系如何映射,聚合什么时候自动发生。
- 第 4 章:类别轴遇上数值轴,八种类别图其实是同一语法在不同统计量上的变奏。
- 第 5 章:热力图与聚类,把整张表当成一个映射对象。
- 第 6 章:颜色是最容易出错的一层映射,定性、顺序、发散三类尺度各有归宿。
- 第 7 章:FacetGrid、PairGrid、JointGrid,分面语法把维度装进面板网格。
- 第 8 章:三个完整案例,从原始数据到可用于报告的成图。
- 第 9 章:大数据量下怎么画不卡、Seaborn 撞到边界时换成什么。
怎么使用本教程
每节开头都会点明承接关系,你既可以顺序读,也可以在遇到具体图形时直接跳到对应章节,用四层拆解法反推参数。所有代码基于 Seaborn 0.13 版本,内置数据集(tips、iris、flights、titanic、penguins)可直接加载,无需额外下载。代码里的注释就是拆解过程本身:哪一行在指定数据,哪一行在做映射,哪一行在叠图层,哪一行在修细节。
准备好 Python 环境后,从第 1 章开始,把第一张图放上拆解台。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...