- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读:把"机器翻译"看成一间双语文档校对间
把你想象成一位坐在双语文档校对间里的译审。桌上摊着一份左右分栏的稿子:左边是英文原句,右边是机器翻出的中文。你的工作不是逐字重译,而是盯着这两栏——看它们对得上对不上、哪一处漏译了、哪一处读起来别扭、哪一处明明是同一个意思却用了完全不同的词。这份教程,就是带你从"看懂两栏对不上"开始,一路走到"知道机器是怎么把左栏变成右栏的,以及怎样让它变得更像人翻的"。
大多数讲机器翻译的教程上来就扔出"编码器""注意力""BLEU"一堆词。这本不这么走。我们始终站在这间校对间里,用译审的眼光去看每一项技术:分词,是给左栏标出一个个可下手的最小单元;对齐,是找两边哪几个词互相对应;注意力,是让机器在翻每一个词时学会回头看左栏哪一点;评测,就是给右栏译文打分定级。技术名词在这里都有了一个"它到底帮我多看懂两栏之间关系"的落脚点。
这间校对间能收获什么
读完这一册,你会得到一条完整的链:一个目标语言句子是怎么从源语言句子那边"长"出来的,以及沿途每一步都可以在哪儿换更好的做法。具体说,你能做到:
- 说清机器翻译的三代路线(规则、统计、神经网络)各自为什么出现、又各自死在/强在哪。
- 亲手从一对句子里定位典型的翻译误差:漏译、错位、不通顺、术语不一致,并判断它卡在链条哪一环。
- 看懂编码器—解码器把一句话"压进去"又"放出来"的流程,理解注意力机制为什么能解决长句信息丢失。
- 对比规则、统计、神经网络三种范式的能力边界,知道什么时候别指望机器翻译。
- 讲出 BLEU 等自动评测指标的原理与致命短板,以及它们和人工评测为何必须配合。
- 面对一个真实项目时,能按语料、工具、框架、部署的次序做出选择。
全册知识地图
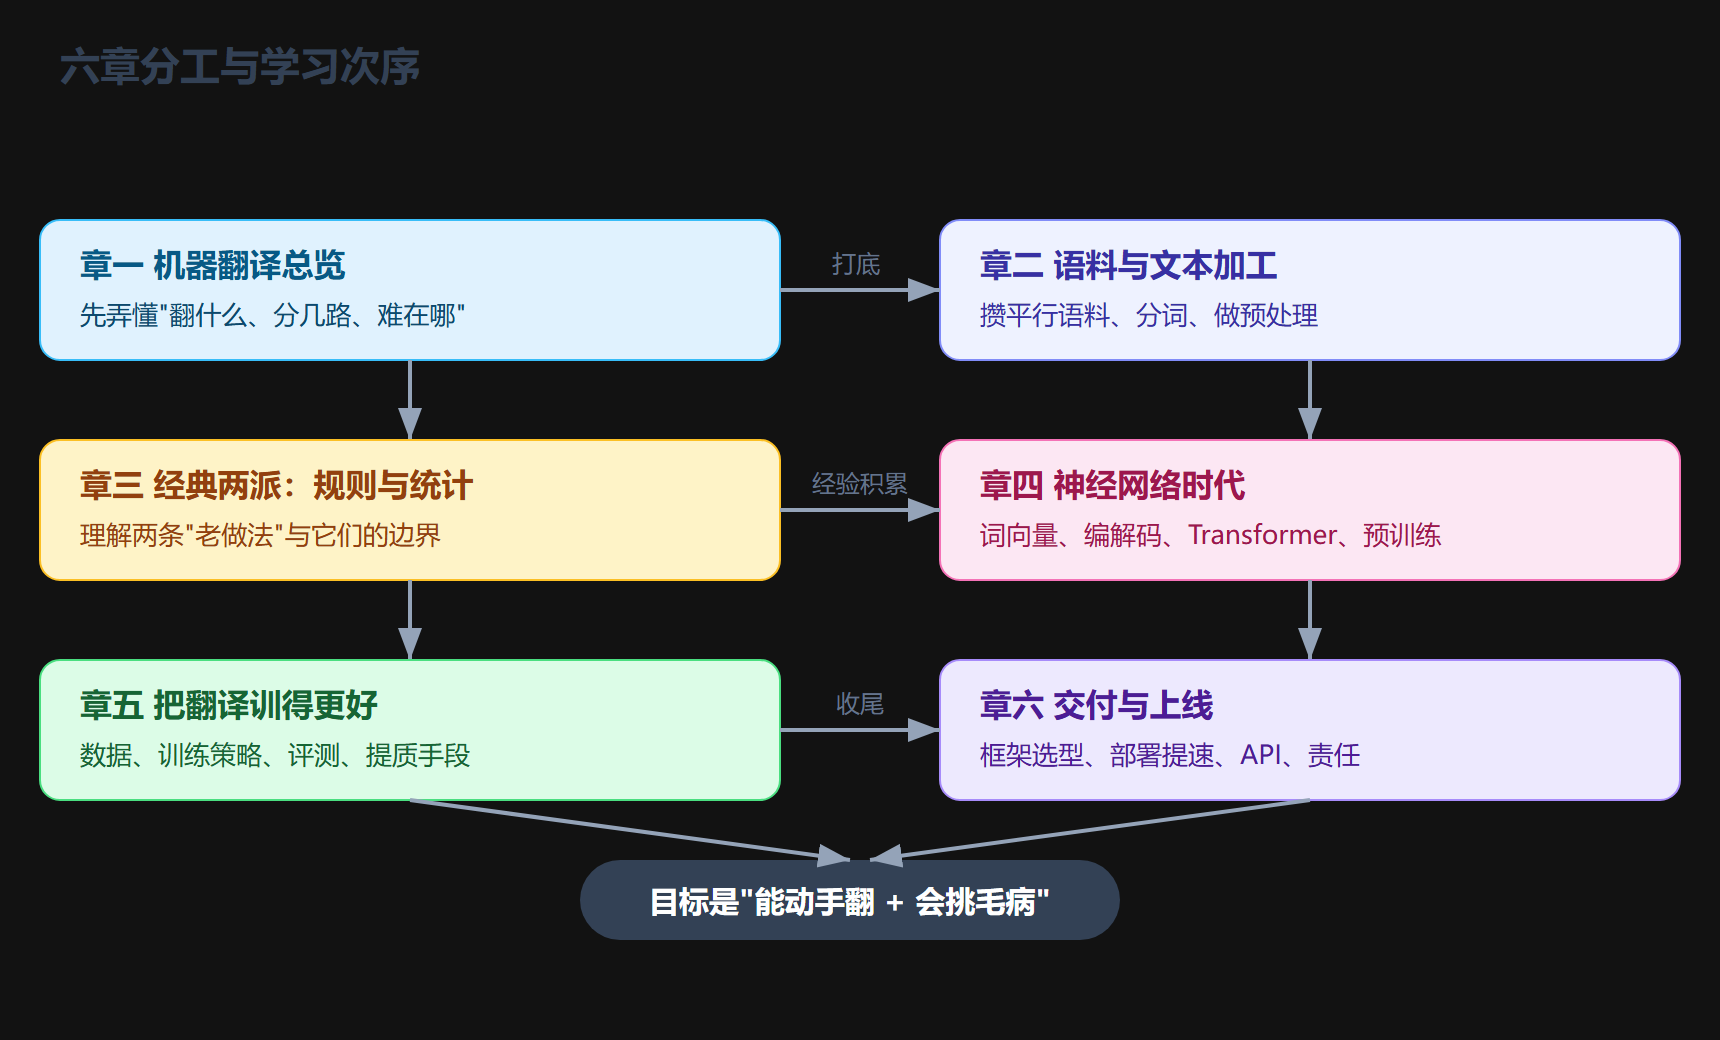
下图标出了六章之间的依赖关系。第一层是"看懂问题",第二层是"准备料",中间三层是"换做法、调机器、看效果",最后收在"交付出去"。前两章打底,三四章是主干,五六章是收尾,不建议跳读第一阶段。
图:本册六章学习依赖地图
建议的读法
前两章可以连着读,当作进入"机器怎么翻"之前的固定动作。到了第三章,如果你对统计机器翻译里的数学细节没兴趣,跳过 GIZA 对齐的计算只记结论也不影响后文——四五六章不依赖它。真正必须扎实的,是第四章的编解码与注意力,它是后面所有谈质量、谈部署的根。第五六章偏工程,建议配合真实工具顺手试一次,比干看有效得多。
关于写作方式的约定
整册保持同一个视角:每次讨论一个技术点,都先问一句"这在校对间里能解决什么看得见的毛病"。因此你会看到大量"两栏对照"式的讲法,也会看到对"机器到底翻错了哪五个地方"的拆解。请带着这份"找茬"的心态读,效果会好得多。每个技术之后,我们都会把它放回一条源句+目标句的样例里验证,而不只是背名词。
如果读到这里你还觉得"机器翻译离我日常很远",那不妨现在就打开任意一个在线翻译,翻一句带歧义的长句——比如前文提到的银行、堤岸混用的那句——然后自问:它错在词义、结构还是不够地道?你能把这条错译归到下面六章里某章的头上,这本导读的使命就已经完成了一半。另一半,留给正文里的每一次"回头看源句"。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...