- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读
一句话定位:AI 伦理与安全不是写在墙上的原则清单,而是招聘拒信、贷款否决、误识别、深度伪造、对齐失败这些已经发生或公开讨论过的事故,倒逼出来的治理与工程问题。本教程问题驱动:先看伤在谁身上,再补框架、法规与止血技术。
这个教程解决什么问题
模型上线时,团队往往只报准确率。出事后才发现:训练数据把历史歧视学进去了;匿名化后的医疗记录仍能被模型反演;自动驾驶在贴纸扰动下把停车标志认错;聊天机器人在上线数小时内学会仇恨言论。这些不是科幻,而是公开报道与学术复盘里反复出现的模式。
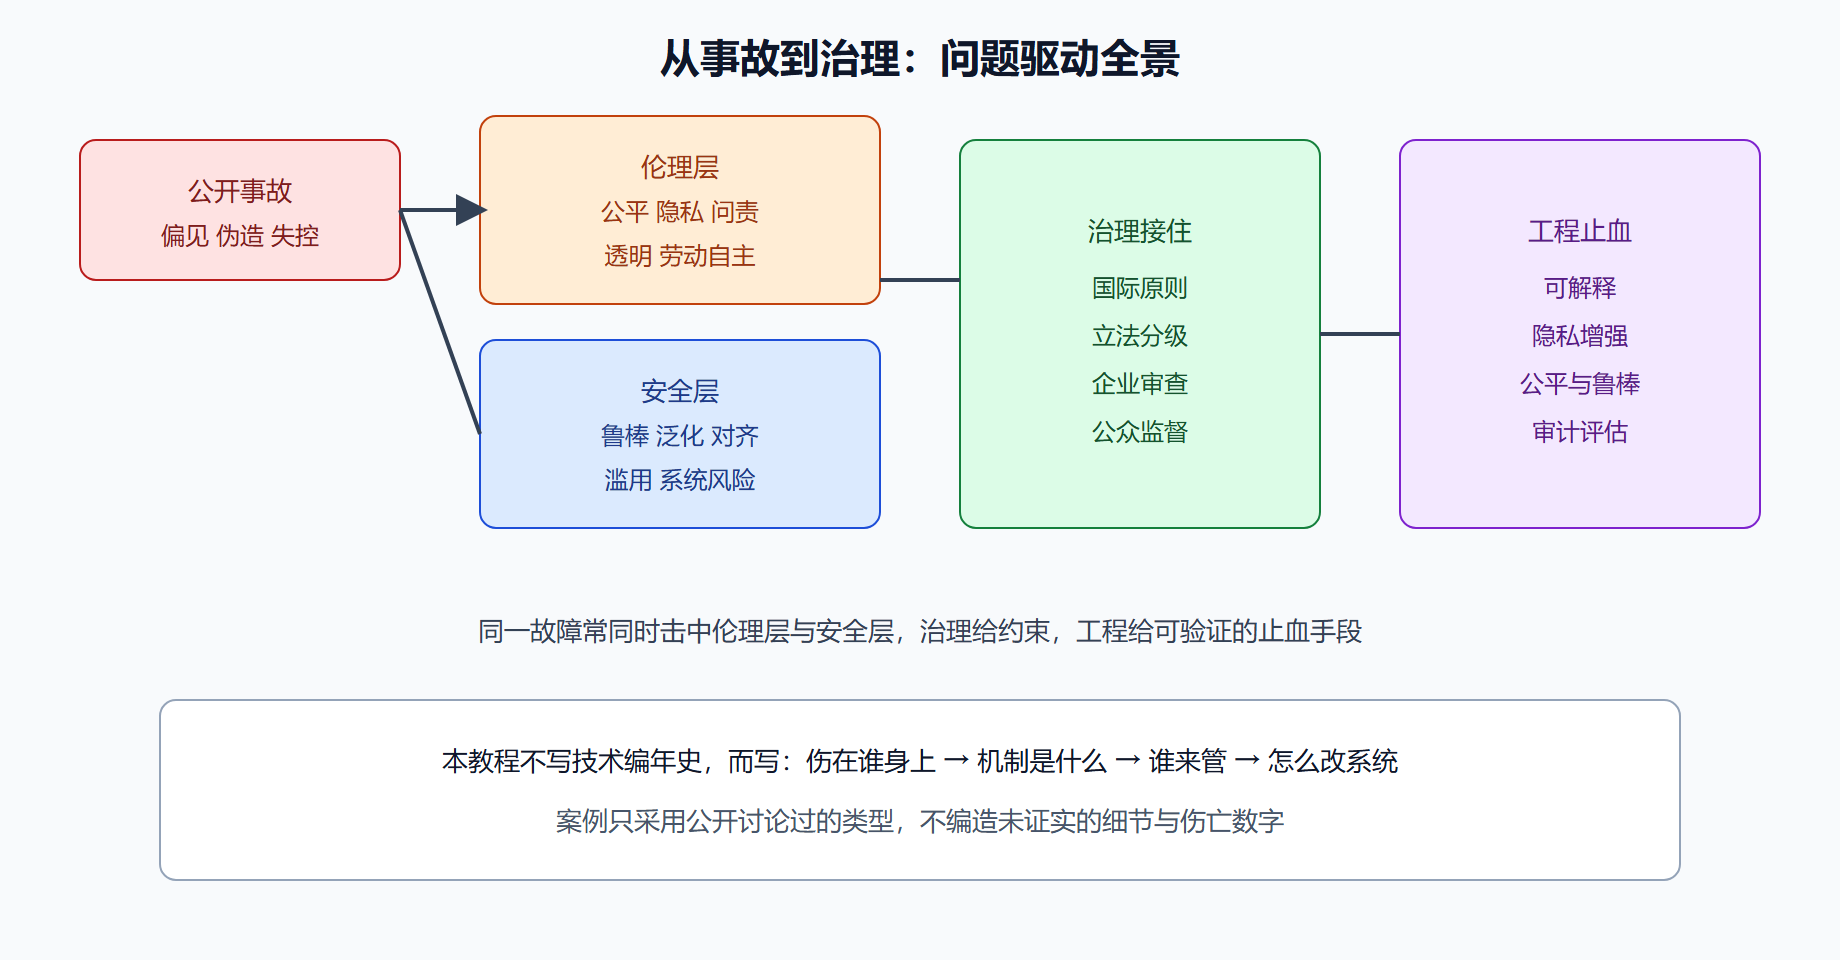
本教程把「伦理」和「安全」放在同一张事故地图上。伦理问的是:决策伤了谁、谁该负责、人还能否做主。安全问的是:系统在扰动、分布偏移、恶意利用下会不会失控。两者经常是同一故障的两面——有偏见的风控模型既不公平,也不可靠。
读完你应能:用风险语言描述一次事故;区分公平性指标为何互相打架;在差分隐私、联邦学习、可解释方法之间做取舍;读懂欧盟人工智能法案那种风险分级在工程上意味着什么。
适合谁读
- 要把模型送进招聘、信贷、医疗、内容审核等对人权有影响场景的工程师与产品负责人
- 需要写影响评估、审计清单、事故复盘的合规与风控同事
- 关心「AI 会不会被滥用、会不会偏离意图」但不想只听口号的研究者与学生
不适合:只想抄对抗攻击代码的读者——那是另一本文集的技术内核。本文集点到 FGSM、LIME、差分隐私的机制,重点在「出事之后怎么判断、怎么管、怎么改」。
学完你能做什么
- 把一次公开争议映射到偏见、隐私、问责、鲁棒、对齐、滥用六类风险,而不是只会说「AI 有伦理问题」。
- 在统计平等、机会均等、均衡赔率之间说明:为什么不能同时满足,以及你的场景该优先哪一个。
- 为高风险系统列出最低限度的人在回路、日志、红队与下线条件。
- 读国际原则与国内立法时,能翻译成「禁止什么、强制评估什么、解释权落到哪一层」。
学习路线
路线故意从事故出发,不从编年史出发。第 1 章把弱人工智能、通用人工智能、对齐、人在回路这些词钉在具体失败上。第 2 章看对人的伤害:偏见、隐私、问责、黑箱、劳动。第 3 章看对系统的伤害:对抗样本、泛化失败、对齐失败、恶意使用、系统性意外。第 4 章看谁来接:教科文组织建议书、经合组织原则、欧盟风险分级、企业内部审查。第 5 章看怎么止血:可解释、隐私增强、公平性干预、鲁棒训练、审计工具。
图 事故如何穿过伦理与安全两层
怎么用这个教程
建议按章顺序读。每节约一到两小时:先看开篇事故,再看表和图,最后用要点回顾当检查清单。高风险业务的读者可把第 2、4、5 章当工作手册,第 3 章当威胁模型补丁。
伦理内容必须严谨。文中提到的刑事风险评估工具争议、人脸识别跨群体精度差异、微软 Tay 聊天机器人被带偏、欧盟人工智能法案风险分级、教科文组织 2021 年伦理建议书,都是公开文献与政策文本里有的。思想实验(如回形针最大化)会标明是思想实验,不当成已发生的事故。
每章末的要点回顾可当检查单。遇到法规条文,以现行有效文本为准,本教程只讲结构:风险分级、数据保护、标识义务如何变成产品规格。伦理写作的纪律贯穿全书:公开争议可引用类型,思想实验必须贴标签,不提供伪造或攻击配方。
| 章 | 你带走什么 |
|---|---|
| 1 | 共同语言与事故地图 |
| 2 | 对人的五种伤害 |
| 3 | 系统如何失效与被滥用 |
| 4 | 谁来接:原则法律标准企业公众 |
| 5 | 怎么改:解释隐私公平鲁棒审计 |
预计每章两到四小时。不需要训练集群,需要把本单位一个真实功能拿来对照。生成式应用额外准备滥用、标识与记忆问题。与对抗机器学习专集同时读时:本教程管门禁、治理与伦理含义,专集管攻击算法与实验细节。导读正文即文集 brief,开篇关键词是人工智能伦理、人工智能安全、偏见、隐私、对齐、滥用、风险分级。只读本页也应带走:先分诊再谈原则;公平指标会打架;没有关停与日志谈不上问责。
先分诊再谈原则:公平指标会打架;没有关停与日志谈不上问责。把本单位一个真实功能钉进偏见、隐私、问责、鲁棒、对齐、滥用六格,钉不住就还没有威胁模型。思想实验必须贴标签,公开争议只引用可核对类型,不提供伪造或攻击配方。
金句:准确率是实验室分数;伦理与安全是系统在真实权力关系里伤没伤人、能不能被关掉。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...