- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读:把模型送进真实世界的那道窄门
别以为把训练好的模型导出成通用格式,部署就水到渠成了——真正的难关从「跑起来」那一刻才开始。无数团队都在同一处栽过跟头:验证集指标漂亮,真机一跑延迟超标;实验室里功耗温和,装进边缘盒子就触发热降频;换一台 CPU,精度居然悄悄掉了。这些坑没有共同的名字,但有共同的身份:它们全是「部署问题」。这本教程写的,就是怎么在动手之前把这些坑提前想清楚,在动手之后一条条排掉。
这本教程的立场:部署是一连串选择题
我们把推理部署看成一条决策链,而不是一份操作手册。每个环节你都在做选择:推理引擎选 OpenVINO 还是 TensorRT、ONNX Runtime?模型走离线转换还是运行时导入?负载跑在 CPU、核显还是 NPU 上?精度压到 INT8 还是继续 FP16?大模型要不要上端侧、上下文给多长?这些选择相互牵连,前面一步决定了后面所有的路。全书七章就是七道大题,每章开头先把问题摆出来,再用实验和案例给出判断依据——不是替你做决定,而是让你做完决定后能说出为什么。
OpenVINO 是英特尔开源的推理工具套件,覆盖模型优化、转换与跨硬件推理执行。它不生产模型,也不替代训练框架,它解决的是模型与硬件之间的「最后一公里」:同一份模型,怎样在不同代际、不同形态的算力上跑得又快又稳。选它作为主线工具,是因为它的决策空间足够典型——设备多样、精度可选、调度策略丰富,学会在这里做权衡,换到任何推理栈都是通用的。
全册知识地图
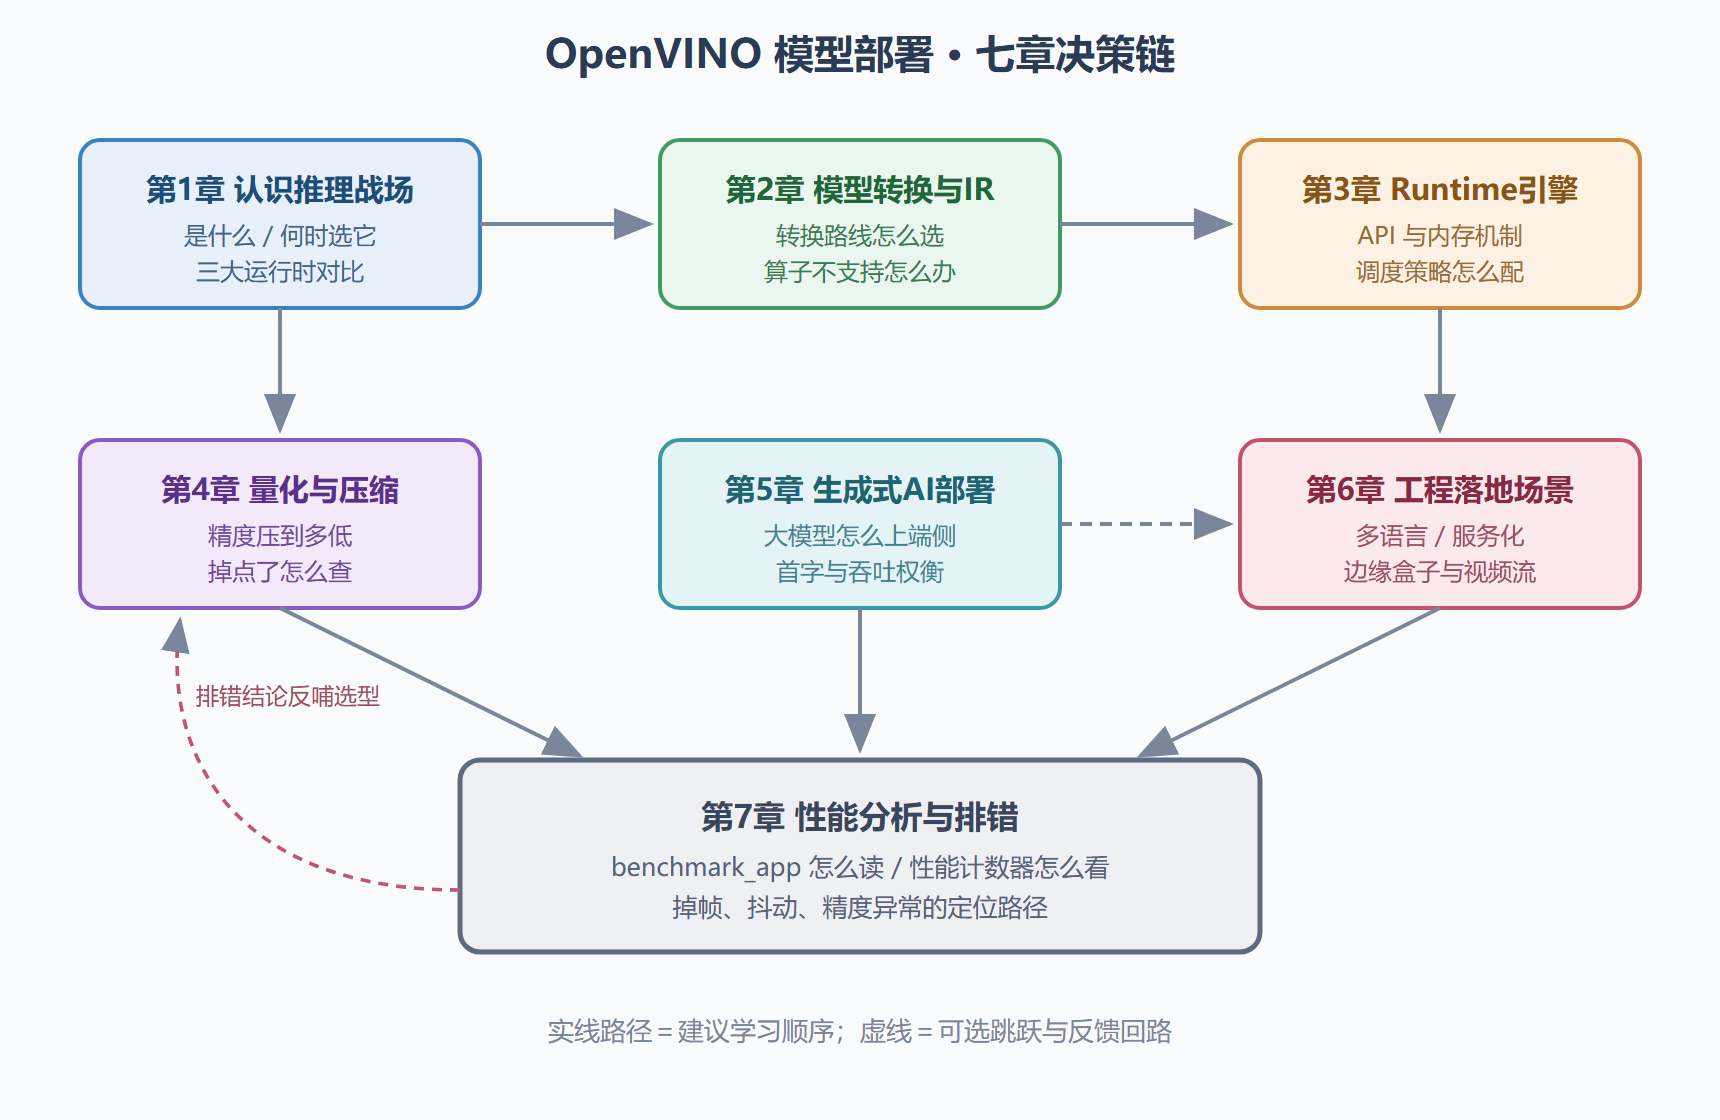
七章的依赖关系如下图:第 1 章是地基,回答「这是什么、什么时候选它」;第 2、3 章是主干,讲透模型转换与运行时机制;第 4 到 6 章是三条应用支线,分别对应压缩、生成式大模型与工程落地;第 7 章收束于度量与排错,反过来支撑前面所有章节。赶时间的读者可以走最小路径(第 1、2、4、7 章),做产品的读者建议按顺序通读。
图 0-1 全册知识地图:七章的依赖与学习路径
读完这本教程你能做什么
把「模型在我机器上跑不快」这类模糊抱怨,换成一组可执行的手艺:能对着硬件清单判断哪块算力适合你的负载与预算;能把 PyTorch 或 ONNX 模型顺利转成 IR,并在算子缺失时知道补、换、绕三条路;能读懂 Runtime 的对象模型,写出同步、异步、流水线三种推理代码;能用 NNCF 把模型压到 INT8,并按一套排查路径处理精度掉点;能搭起从解码、推理到编码的视频结构化流水线;最终能拿 benchmark_app 的报告定位瓶颈在算子、内存还是调度——而不是靠重装环境碰运气。
怎么读这本书
每章开头有一组「本章要回答的问题」,先看问题再决定是否精读;每节都配有可复现的代码、命令会话或实测记录,建议边读边跑。所有实验不挑设备:一台带核显的普通笔记本就够完成大部分内容,有一块 Arc 显卡或 NPU 的读者会看到更明显的加速曲线。书中涉及的具体数值都来自我们自己的测试环境,你的绝对数字几乎必然不同——重要的是判断方法和相对关系,这恰恰是部署工程师最该带走的东西。
版本与约定
内容以 OpenVINO 2023.x 至 2024.x 的 API 形态为准(API 2.0 之后的主线),涉及旧接口处会明确标注差异。示例以 Python 为主、关键处给 C++ 对照;命令行会话统一用 $ 提示符。章节之间的交叉引用一律用「详见第 N 章」的纯文字形式。准备好了,就从第 1 章的第一道选择题开始:你的下一个推理项目,到底该不该用 OpenVINO。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...